Statistical Word Embedding: Makna dari Statistik
Pada pendekatan klasik, kata hanya berupa hitungan — "raja" dan "ratu" sama sekali tidak berhubungan. Statistical word embedding mengambil langkah berikutnya: makna sebuah kata disimpulkan dari statistik kata-kata yang muncul di sekitarnya pada corpus yang sangat besar (misalnya seluruh Wikipedia).
Yang akan kita pelajari di halaman ini:
- Word Embedding - Setiap kata punya "scorecard"-nya sendiri
- Gensim - Pintu masuk praktis ke dunia embedding siap pakai
- GloVe - Kamus embedding dari matriks co-occurrence global
- FastText - Embedding yang mengerti potongan kata
- Simulasi Interaktif - Vektor, kesamaan kata, dan analogi
Word Embedding: Setiap Kata Memiliki Datanya Masing-Masing
Word embedding itu seperti "scorecard" untuk setiap kata. Memanfaatkan word embedding itu tentang memahami bahwa setiap kata dapat mengandung informasinya masing-masing, entah itu tentang:
- Gender - Apakah kata ini maskulin atau feminin?
- Aturan gramatikal - Apakah ini kata kerja, kata benda, atau kata sifat?
- Makna - Apa arti kata ini dalam berbagai konteks?
- Hubungan - Kata apa saja yang sering muncul bersamaan?
Bayangkan setiap kata memiliki "profil" dengan berbagai karakteristik yang diukur dalam bentuk angka. Kata-kata dengan makna serupa akan memiliki profil yang mirip!
Kenapa disebut "statistical"?
Karena angka-angka pada scorecard tersebut tidak ditulis manusia, melainkan dihitung dari statistik kemunculan kata di corpus besar. Model tidak pernah diberi tahu arti "raja" — ia hanya melihat kata apa saja yang biasanya muncul di sekitarnya.
Gensim: Pintu Masuk ke Word Embedding
Gensim adalah library Python yang menjadi standar praktis untuk bekerja dengan word embedding. Gensim tidak "membuat" jenis embedding baru — ia adalah alat untuk memuat, melatih, menyimpan, dan menanyakan embedding seperti GloVe, FastText, maupun Word2Vec.
- Memuat embedding siap pakai - Unduh GloVe/FastText pre-trained dengan satu baris kode
- Melatih embedding sendiri - Latih di corpus domain Anda (ulasan produk, berita, dll)
- Query kesamaan -
most_similar(),similarity(), analogi kata - Efisien untuk corpus besar - Streaming data, tidak harus muat di memori sekaligus
Contoh Penggunaan
import gensim.downloader as api
model = api.load("glove-wiki-gigaword-100")
# Kata apa yang paling mirip dengan "king"?
model.most_similar("king")
# [('queen', 0.75), ('prince', 0.73), ('monarch', 0.72), ...]
# Analogi: king - man + woman = ?
model.most_similar(positive=["king", "woman"], negative=["man"])
# [('queen', 0.77), ...]
Kata Positif & Negatif
Anda dapat menambahkan kata-kata positif (kata yang ingin Anda cari kemiripannya) dan kata-kata negatif (kata yang ingin Anda hindari dalam pencarian). Ini memungkinkan pencarian yang lebih spesifik — dan inilah cara analogi kata dihitung!
Relasi Banyak Kata Sekaligus
Kita juga dapat mencoba memvisualisasikan relasi kata untuk beberapa kata sekaligus, sehingga kita dapat mengetahui apa yang word embedding "pikirkan" tentang bagaimana beberapa kata berhubungan dengan yang lain.
🔍 Visualisasi Interaktif Word Embedding
Eksperimen dengan relasi kata, cosine similarity, dan visualisasi multi-dimensi di Google Colab
Buka di Google ColabGloVe: Global Vectors for Word Representation
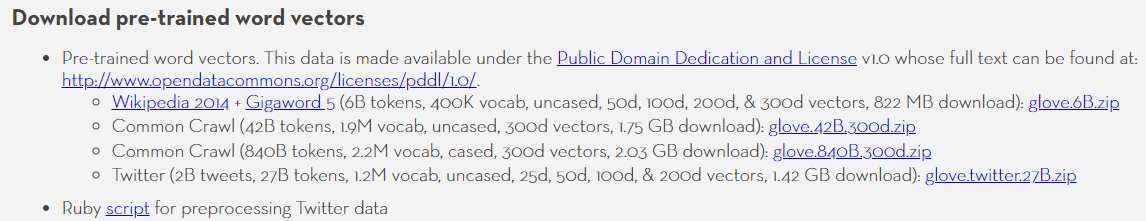
Salah satu kamus word embedding terpopuler adalah GloVe (Global Vectors for word representation). GloVe pada dasarnya adalah kamus word embedding dalam bahasa Inggris yang mengumpulkan ratusan ribu hingga jutaan kosakata & memetakan setiap kosakata ke matriks word embedding yang dikhususkan untuk masing-masing kosakata.
NLP & Kata-kata: Masalah dalam Menemukan Relasi
Secara garis besar word embedding dihasilkan dengan mempelajari relasi kata. Mari kita lihat contoh di atas untuk melihat sebuah kata & kata-kata apa saja yang GloVe pelajari memiliki kaitan dengan kata tersebut.
Contoh: Relasi untuk kata "king"
GloVe word embedding menciptakan relasi dari kata "king" ke kata-kata lain:
- "queen" adalah istilah untuk istri raja
- "empire", "kingdom" adalah istilah tentang wilayah kekuasaan raja
- "death" adalah istilah yang berarti seorang raja bisa meninggal
Tentu saja sulit untuk benar-benar menentukan konteks apa yang GloVe pahami untuk sebuah kata, mengapa GloVe "berpikir" bahwa sebuah kata berhubungan dengan kata lain — word embedding sebagian besar kekurangan kemampuan untuk menjelaskan pembuatan relasi mereka, kita hanya bisa menebak.
Kesamaan dalam Konteks
Satu terminologi yang harus Anda tahu adalah ketika kita memeriksa bagaimana sebuah kata berhubungan dengan kata lain, istilah itu sebagian besar disebut "kesamaan" (similarity). Kesamaan berarti seberapa mirip kata yang diberikan dengan konteks untuk kata lain, dalam konteks NLP yang kita berikan, kesamaan sebagian besar berarti:
- Seberapa sering dua kata muncul bersama dalam sebuah kalimat berdekatan satu sama lain
- Bagaimana dua kata bahkan ketika tidak sering muncul bersama, sebagian besar dipasangkan dengan kata-kata serupa. Contohnya: car sering muncul dengan kata drive, & bus juga sering muncul dengan kata drive.
Catatan: Kita menggunakan data dari Wikipedia untuk menghasilkan word embedding. Semakin banyak teks yang dikumpulkan dapat memberikan konteks yang lebih baik & kurangnya sumber ini dapat melemahkan akurasi word embedding dalam memberikan konteks ke setiap kata.
FastText: Embedding yang Mengerti Potongan Kata
GloVe memperlakukan setiap kata sebagai satu unit utuh. Akibatnya, kata yang tidak pernah muncul saat training (out-of-vocabulary) tidak punya vektor sama sekali — dan "main", "bermain", "memainkan" dianggap tiga kata yang tak berhubungan.
FastText (dari Facebook AI Research) memperbaiki ini dengan memecah setiap kata menjadi sub-kata (character n-grams). Vektor sebuah kata adalah jumlah dari vektor potongan-potongannya.
Karena "bermain" dan "memainkan" berbagi potongan "mai" dan "ain", vektornya otomatis berdekatan — tanpa perlu melihat kedua kata itu bersamaan.
Keunggulan FastText
- Menangani kata baru (OOV) - Kata yang belum pernah dilihat tetap bisa diberi vektor dari potongannya
- Cocok untuk bahasa berimbuhan - Bahasa Indonesia dengan awalan/akhiran sangat terbantu
- Tahan terhadap typo - "makanan" dan "makanaan" masih berbagi banyak n-gram
- Tersedia untuk 157 bahasa - Termasuk bahasa Indonesia, siap dipakai lewat Gensim
Perbandingan Statistical Word Embedding
| Aspek | GloVe | FastText |
|---|---|---|
| Unit dasar | Kata utuh | Sub-kata (character n-gram) |
| Sumber sinyal | Matriks co-occurrence global | Konteks jendela + potongan kata |
| Kata baru (OOV) | Tidak punya vektor | Tetap dapat vektor |
| Bahasa berimbuhan | Kurang optimal | Lebih baik |
| Ukuran model | Lebih ringan | Lebih besar (menyimpan n-gram) |
import gensim.downloader as api
ft = api.load("fasttext-wiki-news-subwords-300")
ft.most_similar("programming")
# bahkan kata yang tidak ada di vocabulary tetap bisa diberi vektor
Simulasi: Memahami Vektor
Vektor memiliki magnitude (besar) dan arah. Eksplorasi dengan slider di bawah:
Vektor A
Vektor B
Cosine similarity mengukur sudut antar vektor, bukan jarak. Nilai 1 = arah sama, 0 = tegak lurus, -1 = berlawanan.
Simulasi: Visualisasi Kata
Kata dengan makna serupa memiliki vektor yang berdekatan dalam ruang vektor:
Kata-kata Terdekat:
Visualisasi 2D ini adalah proyeksi dari ruang berdimensi tinggi. Kata yang dekat memiliki makna atau konteks penggunaan yang serupa.
Simulasi: Analogi Kata
Word embedding memungkinkan kita melakukan "matematika" pada kata. Contoh klasik: Raja - Pria + Wanita = Ratu