Neural Network Embedding: Belajar Representasi Kata
Pada dua materi sebelumnya, representasi kata dibuat dengan menghitung. Sekarang kita membiarkan neural network yang belajar sendiri representasi terbaik untuk setiap kata — mulai dari jaringan dua layer sederhana (Word2Vec) sampai model transformer besar seperti BERT dan BART.
Dalam pembelajaran ini, kita akan memahami:
- Kenapa perlu neural embedding - Masalah one-hot dan keunggulan dense vector
- Skip-gram & CBOW - Dua arsitektur Word2Vec
- Kekuatan relasi - Mengukur hubungan antar kata dengan cosine similarity
- BERT - Embedding yang berubah mengikuti konteks kalimat
- BART - Encoder-decoder untuk tugas generatif
Masalah One-Hot Encoding
Meskipun One-Hot Encoding lebih baik dari ASCII, metode ini memiliki beberapa kelemahan serius:
- Dimensi sangat besar - Jika vocabulary memiliki 10,000 kata, setiap kata direpresentasikan dengan vektor 10,000 dimensi
- Vektor sangat sparse - Hanya satu elemen bernilai 1, sisanya 0. Ini sangat boros memori
- Tidak ada relasi antar kata - "king" dan "queen" direpresentasikan sama independennya dengan "king" dan "apple"
Neural network embedding lahir untuk menjawab tepat masalah ini: alih-alih menentukan angka secara manual, biarkan jaringan belajar angka mana yang paling berguna untuk memprediksi konteks sebuah kata.
Apa Arti Angka di Dalam Vektor?
Sampai di sini kita sudah tahu bahwa setiap kata diwakili sederet angka. Yang belum kita jawab: angka-angka itu artinya apa? Pertanyaan ini penting, karena di sinilah letak perbedaan terbesar antara neural embedding dan semua metode sebelumnya.
Pada Metode Sebelumnya, Dimensi Punya Label
Di one-hot, BoW, dan TF-IDF, kita selalu bisa menunjuk arti setiap kolom: kolom ke-57 adalah kata "murah", kolom ke-912 adalah kata "mahal". Dimensinya kita tentukan sendiri, dan jumlahnya sebanyak ukuran vocabulary.
Pada Neural Embedding, Dimensi Tidak Berlabel
Neural network diberi kebebasan memakai, misalnya, 100 dimensi untuk menyimpan apa saja yang menurutnya paling berguna untuk memprediksi konteks sebuah kata. Tidak ada seorang pun yang memberi tahu dimensi ke-1 harus berisi "gender" atau dimensi ke-2 harus berisi "tempat" — jaringan menemukannya sendiri dari pola pemakaian kata di data.
# dim-0 dim-1 dim-2 dim-3 ...
"raja" = [ 0.2, 0.8, 0.1, 0.9, ...]
"ratu" = [ 0.3, 0.7, 0.2, 0.8, ...]
"mobil" = [ 0.1, 0.1, 0.9, 0.2, ...]
# "raja" dan "ratu" berdekatan di hampir semua dimensi
# "mobil" jauh dari keduanya, terutama di dim-2
Setelah model dilatih, kita bisa menebak dimensi mana yang seolah-olah menangkap konsep tertentu:
- Ada dimensi yang nilainya berbeda jauh antara "raja" dan "ratu" — mirip konsep gender
- Ada dimensi yang memisahkan benda hidup dari benda mati
- Ada dimensi yang memisahkan tempat dari kendaraan
Konsekuensi Praktisnya
Karena dimensinya tidak berlabel, kita tidak menilai embedding dari isi angkanya, melainkan dari jarak antar vektor: kata yang dipakai dalam konteks serupa harus berdekatan. Slide berikutnya menunjukkan cara berpikir itu bekerja pada sebuah kalimat.
Konteks Multidimensi
Mari kita pahami dengan contoh sederhana. Bayangkan kita ingin melengkapi kalimat:
"Andi masuk ke dalam ___"
Model akan mencari kata yang memiliki nilai tinggi untuk dimensi:
- Tempat - rumah, toko, kantor (cocok)
- Kendaraan - mobil, bus, kereta (cocok)
Dan menghindari kata yang tidak masuk akal:
- Benda kecil - buku, gelas, pulpen (tidak cocok)
- Bagian tubuh - telinga, mata, kaki (tidak cocok)
Keunggulan Word Embedding
Word Embedding mengatasi semua kelemahan One-Hot Encoding dengan pendekatan yang lebih cerdas:
- Vektor lebih kecil - Biasanya 50-300 dimensi, bukan ribuan
- Vektor dense - Semua nilai bermakna, tidak ada yang terbuang
- Menangkap relasi semantik - Kata mirip memiliki vektor yang dekat
Relasi yang Ditangkap
Word embedding dapat menangkap berbagai jenis relasi:
Sinonim: Kata dengan arti mirip memiliki vektor yang mirip
Analogi: king - man + woman ≈ queen
Relasi tematik: Paris, Rome, Berlin semua dekat (ibukota Eropa)
Konsep Word2Vec
Konsepnya cukup simpel jika kita coba untuk dalami dulu intuisinya:
- Input: One-hot encoded vector yang merepresentasikan input word kita
- Hidden Layer: Setiap neuron merepresentasikan konteks berbeda yang didapatkan dari training (tense, gender, dll)
- Output Layer: Menggunakan softmax untuk menghasilkan probabilitas untuk setiap word di vocabulary
Prinsip Utama:
Kata-kata yang muncul dalam konteks yang sama cenderung memiliki makna yang berhubungan. Word2Vec memanfaatkan prinsip ini untuk membangun representasi vektor.
Intuisi: Menghubungkan Words
Mari kita lihat contoh sederhana untuk memahami bagaimana Word2Vec belajar:
Contoh 1: "king" dan "ruler"
Jika kita membaca banyak kalimat seperti:
- "the king ordered the citizens to leave the city"
- "the ruler ordered the citizens to leave the city"
- "the king commanded the citizens to evacuate the city"
- "the ruler commanded the citizens to evacuate the city"
Contoh 2: "fish" dan "water"
Perhatikan kalimat-kalimat ini:
- "fish swims in the water"
- "the water is home to many fish"
- "the fish is dead because of the polluted water"
- "water is essential for fish to live"
Pertanyaan:
"fish" dan "water" sering muncul bersamaan. Haruskah kita menyimpulkan bahwa mereka dekat satu sama lain di vector space?
Jawaban: Ya! Word2Vec akan belajar bahwa kedua kata ini memiliki hubungan yang erat.
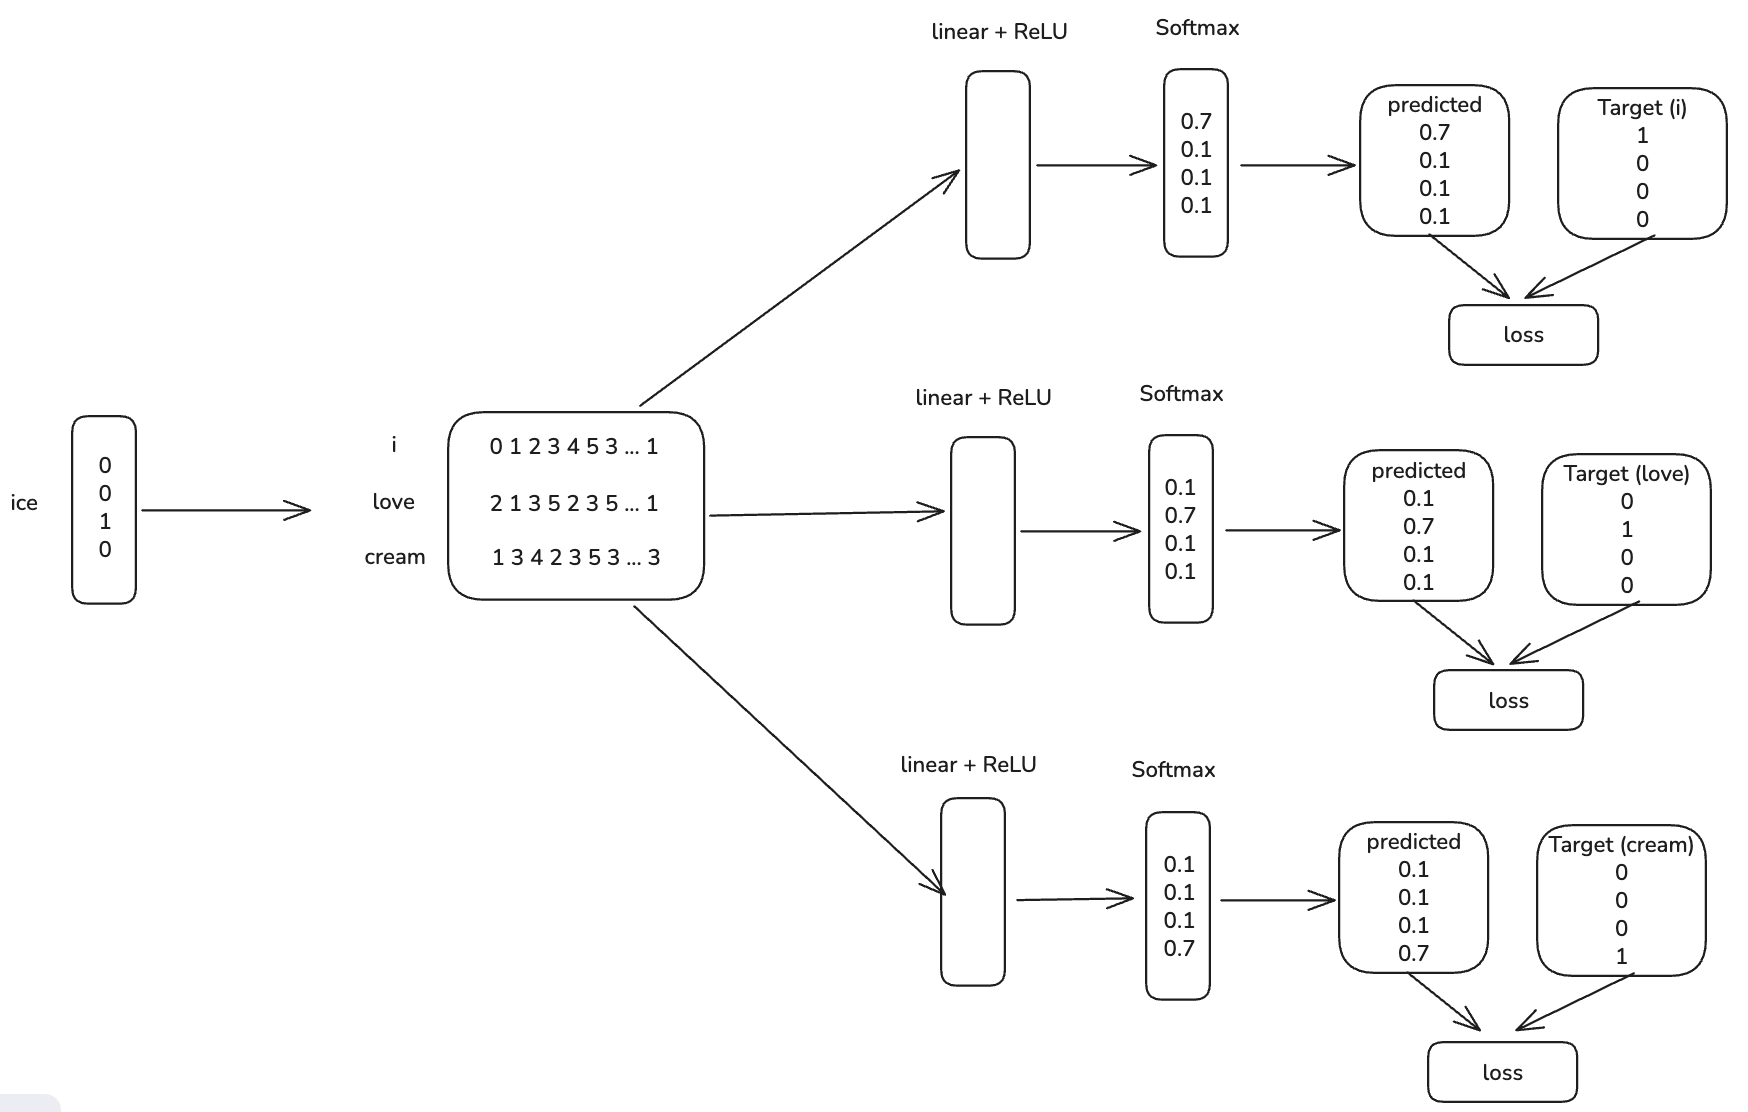
Skip-gram: Memprediksi Konteks
Skip-gram memprediksi kata-kata dalam range tertentu sebelum dan sesudah sebuah kata dalam sebuah kalimat.
Contoh dengan Window Size = 2
Kalimat: "I love to eat fish, but I hate to drink water"
| Window Size | Input | Predicted Output |
|---|---|---|
| 2 | love | (I, to, eat) |
| 2 | eat | (love, to, fish, but) |
| 2 | fish | (to, eat, but, I) |
CBOW: Continuous Bag of Words
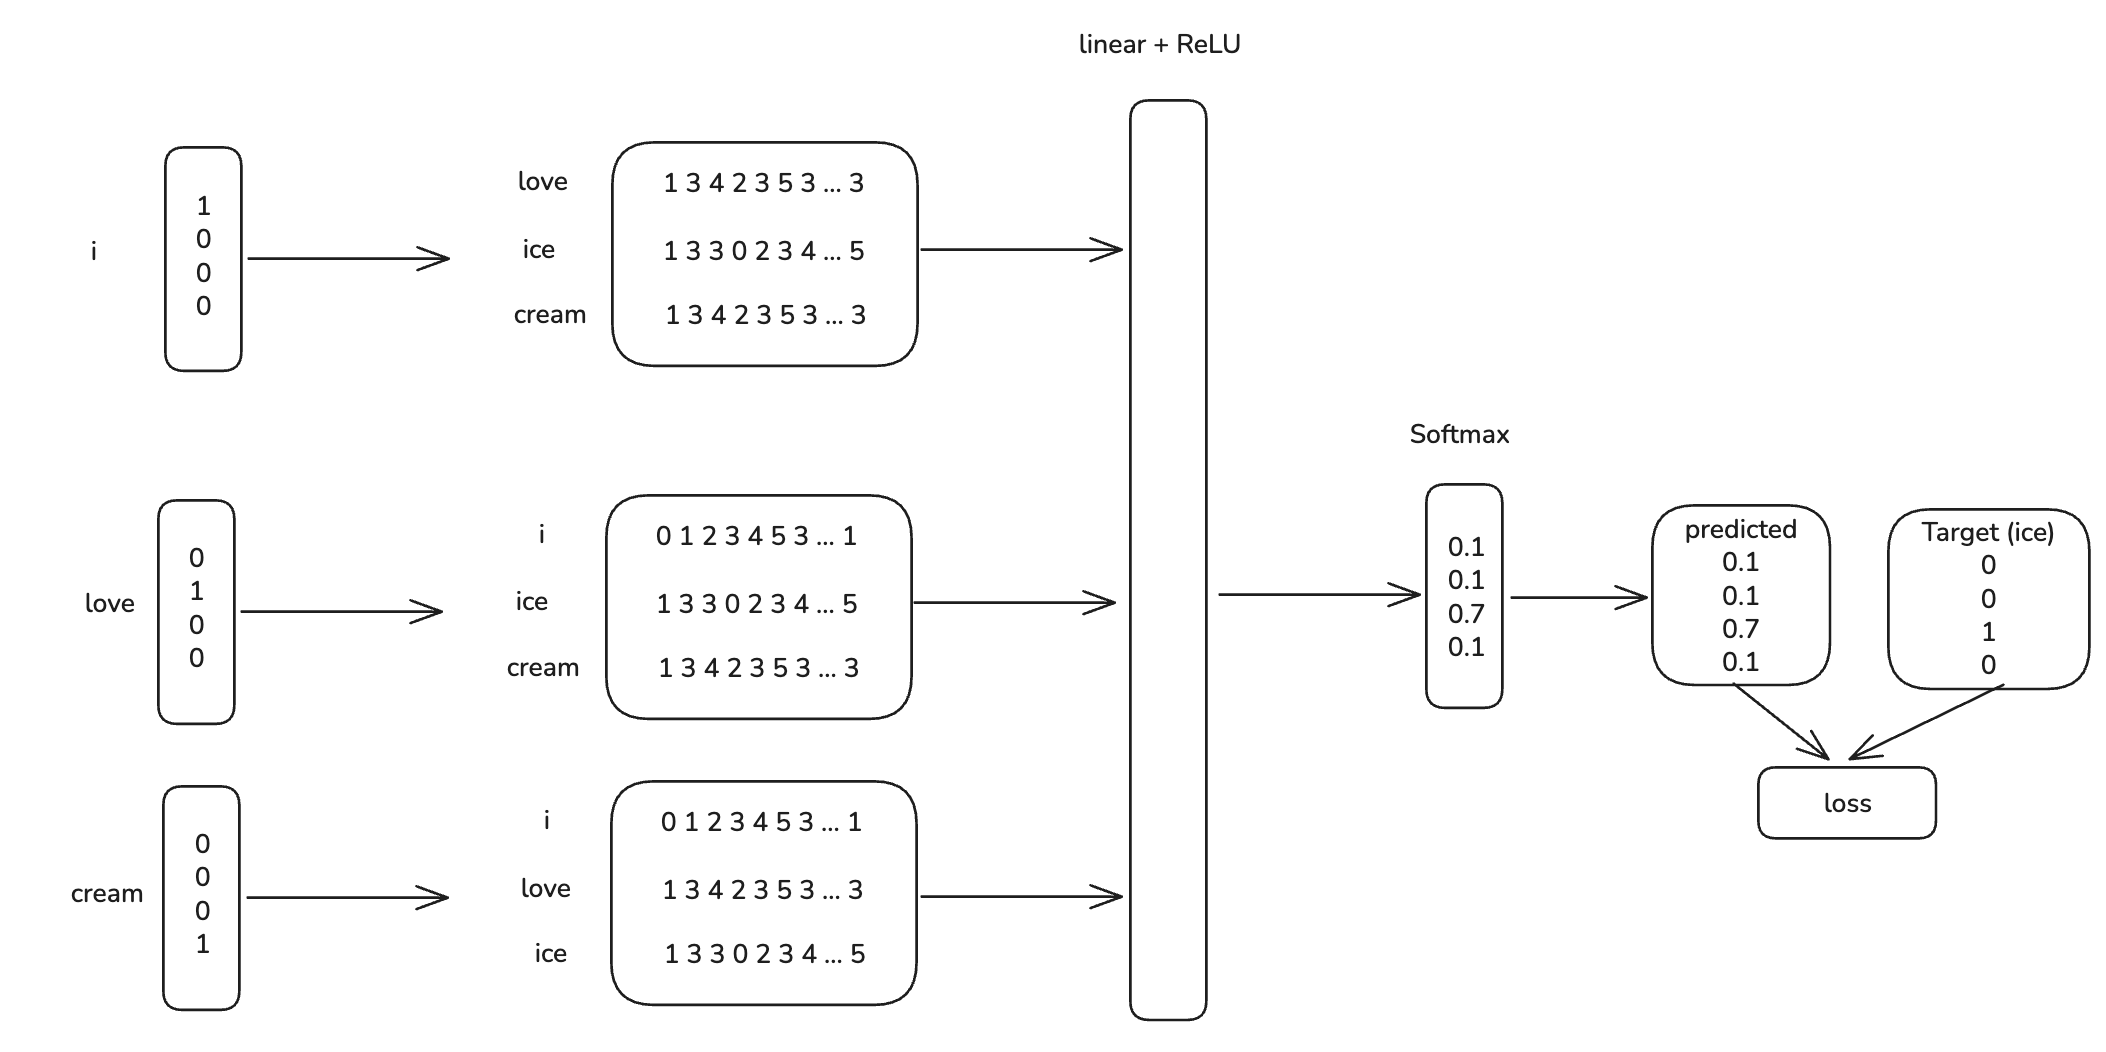
CBOW adalah kebalikan dari Skip-gram. Ini memprediksi kata tengah berdasarkan konteks dari beberapa kata sebelum dan sesudahnya.
Contoh dengan Window Size = 2
Kalimat: "I love to eat fish, but I hate to drink water"
| Window Size | Input (Context) | Predicted |
|---|---|---|
| 2 | ( I, to eat) | love |
| 2 | (love to, fish, but) | eat |
| 2 | (to eat, but I) | fish |
Skip-gram vs CBOW
| Aspek | Skip-gram | CBOW |
|---|---|---|
| Input | Kata tengah | Kata konteks |
| Output | Kata konteks | Kata tengah |
| Kecepatan | Lebih lambat | Lebih cepat |
| Dataset Kecil | Lebih baik | Kurang optimal |
| Kata Langka | Lebih baik | Kurang optimal |
Simulasi: Cara Kerja Skip-gram & CBOW
Klik sebuah kata pada kalimat di bawah untuk melihat bagaimana Skip-gram dan CBOW memproses kata tersebut.
Kalimat Simulasi
Pasangan Data Training
Klik sebuah kata pada kalimat...
Simulasi: Bagaimana Relasi Terbentuk
Kata-kata yang muncul dalam konteks yang sama cenderung memiliki makna yang berhubungan. Perhatikan contoh di bawah ini.
Contoh Kalimat (Corpus)
the wise king sits on the royal throne
the wise queen sits on the royal throne
a good king is a just ruler
a good queen is a just ruler
Analisis Konteks
Konteks untuk king:
Kata-kata yang muncul di dekat "king": wise, sits, on, royal, throne, good, is, just, ruler
Konteks untuk queen:
Kata-kata yang muncul di dekat "queen": wise, sits, on, royal, throne, good, is, just, ruler
Kesimpulan
Karena king dan queen sering muncul dalam konteks yang sangat mirip (dikelilingi oleh kata-kata yang sama), Word2Vec menyimpulkan bahwa keduanya memiliki relasi semantik yang kuat. Vektor mereka akan menjadi sangat berdekatan.
Melihat Bagaimana Beberapa Kata Saling Berhubungan
Cara lain untuk memvisualisasikan hasil embedding adalah dengan memeriksa kekuatan relasi sebuah kata dengan beberapa kata lainnya.
Misalkan Anda ingin tahu apakah seorang queen lebih terkait dengan kata "he" atau "she", Anda dapat memeriksa kekuatannya menggunakan cosine similarity.
Kenapa penting?
Kekuatan relasi inilah "bukti" bahwa neural network benar-benar belajar sesuatu tentang makna. Setelah training, kita bisa mengukurnya secara numerik — bukan sekadar menebak.
Implementasi Word2Vec
Cara termudah untuk membangun Word2Vec model adalah dengan menggunakan library gensim.
kalimat = [["raja", "duduk", "di", "singgasana"],
["ratu", "duduk", "di", "kursi"]]
# sg=1 → Skip-gram, sg=0 → CBOW
model = Word2Vec(kalimat, vector_size=100, window=2, min_count=1, sg=1)
model.wv.most_similar("raja")
💻 Praktikkan di Google Colab
Implementasikan Word2Vec dengan library Gensim secara langsung
Buka di Google ColabContext-Aware Embedding vs Static Embedding
Word2Vec, GloVe, dan FastText punya satu keterbatasan yang sama: satu kata selalu punya satu vektor. Di sinilah perbedaan antara context-aware embeddings & static embeddings menjadi penting.
Perhatikan kata bank dalam dua
kalimat berikut:
🏦 "I need to go to the bank to deposit my paycheck."
🌊 "We sat by the river bank and watched the sunset."
Kata "bank" memiliki banyak arti yang mungkin. Static word embedding seperti GloVe hanya memiliki satu vektor untuk kata "bank", yang merupakan rata-rata dari semua konteks yang pernah dilihat model. Akibatnya, vektor tersebut tidak sepenuhnya mewakili makna di kalimat pertama (bank keuangan) maupun kalimat kedua (tepi sungai).
Sebaliknya, context-aware embedding membaca seluruh kalimat terlebih dahulu, kemudian menghasilkan vektor yang berbeda untuk kata "bank" di setiap kalimat, sehingga model memahami konteks yang tepat dan tidak mencampurkan kedua makna tersebut.
Perbedaan Utama
- Static Embedding (contoh: Word2Vec, GloVe, FastText): Setiap kata memiliki satu vektor tetap, tidak peduli konteksnya
- Context-Aware Embedding (contoh: BERT): Vektor kata berubah tergantung pada konteks kalimatnya
Contoh untuk context-aware embedding adalah BERT, yang akan kita selami di bagian berikutnya.
BERT: Bidirectional Encoder Representations from Transformers
BERT adalah model transformer encoder-only dari Google yang menghasilkan embedding per token, per kalimat. Kata yang sama pada kalimat berbeda mendapat vektor yang berbeda — inilah context-aware embedding yang kita bicarakan sebelumnya.
Cara BERT Dilatih
-
Masked Language Modeling (MLM) - Sekitar 15% kata ditutup
(
[MASK]), lalu model menebak kata yang hilang berdasarkan seluruh kalimat - Next Sentence Prediction (NSP) - Model menebak apakah kalimat B benar-benar kalimat lanjutan dari kalimat A
"Saya pergi ke [MASK] untuk menabung."
Prediksi model: bank (0.82), koperasi (0.07), atm (0.04)
Kenapa BERT Penting?
- Satu kata, banyak vektor - Makna ditentukan oleh kalimatnya
- Transfer learning - Cukup fine-tune untuk klasifikasi sentimen, NER, QA
- Sentence embedding - Token
[CLS]dapat dipakai sebagai representasi seluruh kalimat - Tersedia untuk bahasa Indonesia - Misalnya IndoBERT dan multilingual BERT
tokenizer = AutoTokenizer.from_pretrained("indobenchmark/indobert-base-p1")
model = AutoModel.from_pretrained("indobenchmark/indobert-base-p1")
# vektor "bank" akan berbeda di dua kalimat ini
emb1 = model(**tokenizer("saya menabung di bank", return_tensors="pt")).last_hidden_state
emb2 = model(**tokenizer("kami duduk di bank sungai", return_tensors="pt")).last_hidden_state
💻 Praktik BERT Embedding
Eksplorasi context-aware embedding dari BERT secara langsung di Google Colab
Buka di Google ColabCatatan Arsitektur
BERT hanya memakai bagian encoder dari transformer. Karena itu ia sangat kuat untuk memahami teks (klasifikasi, pencarian, ekstraksi), tetapi tidak dirancang untuk menghasilkan teks panjang. Untuk itu kita butuh arsitektur berikutnya: BART.
BART: Bidirectional and Auto-Regressive Transformers
BART (Facebook AI) menggabungkan dua dunia: encoder dua arah seperti BERT untuk memahami input, dan decoder auto-regressive seperti GPT untuk menghasilkan output kata demi kata.
Jenis "Perusakan" Teks saat Training
- Token masking - Kata tertentu diganti dengan token mask
- Token deletion - Kata dihapus, model harus tahu di mana kata hilang
- Text infilling - Beberapa kata sekaligus diganti satu token mask
- Sentence permutation - Urutan kalimat diacak
- Document rotation - Dokumen diputar sehingga mulai dari kata acak
BERT vs BART
| Aspek | BERT | BART |
|---|---|---|
| Arsitektur | Encoder saja | Encoder + Decoder |
| Pretraining | Masked Language Modeling | Denoising (masking, infilling, permutation) |
| Output alami | Vektor / label | Teks baru |
| Cocok untuk | Klasifikasi, NER, QA, similarity | Ringkasan, terjemahan, parafrase |
| Embedding | Context-aware per token | Context-aware + representasi untuk generasi |
ringkas = pipeline("summarization", model="facebook/bart-large-cnn")
ringkas(teks_panjang, max_length=80)
# BART membaca seluruh teks (encoder), lalu menuliskan ringkasan (decoder)
Menutup Perjalanan Embedding
Kita mulai dari menghitung karakter (ASCII), lalu menghitung kata (BoW, TF-IDF), lalu menghitung statistik konteks (GloVe, FastText), sampai akhirnya membiarkan neural network membaca seluruh kalimat (Word2Vec → BERT → BART). Konsep encoder-decoder dan attention yang dipakai BERT & BART akan kita bahas lebih dalam di materi berikutnya.
Demo: Melihat Encoded Text
Sekarang kita sudah paham bagaimana BART membaca teks. Mari lihat sendiri hasilnya: bagaimana sebuah kalimat diubah menjadi angka oleh model transformer modern, memakai BART untuk encoding.
💻 Praktikkan di Google Colab
Yuk, jalankan code dan lihat bagaimana text di-encode menjadi angka!
Buka di Google ColabYang Perlu Diperhatikan
Amati bahwa satu kata bisa dipecah menjadi beberapa token, dan setiap token punya id angkanya sendiri. Dari id inilah model mengambil vektor embedding yang kita bahas sepanjang materi ini.