Classical Word Embedding: Dari Teks ke Angka
Sebelum ada neural network, komputer sudah harus mengubah teks menjadi angka. Kelompok teknik paling awal ini kita sebut classical word embedding: representasi yang dibuat murni dengan menghitung — menghitung karakter, menghitung posisi kata dalam vocabulary, dan menghitung frekuensi kemunculan kata.
Dalam pembelajaran ini kita akan menjelajahi lima teknik klasik secara berurutan, dari yang paling sederhana hingga yang paling berguna untuk model klasik:
- ASCII Encoding - Cara paling dasar komputer menyimpan teks
- One-Hot Encoding - Setiap kata mendapat posisi unik dalam vocabulary
- Bag of Words (BoW) - Menjumlahkan one-hot menjadi satu vektor dokumen
- Term Frequency (TF) - Frekuensi kata yang dinormalisasi panjang dokumen
- TF-IDF - Menurunkan bobot kata umum, menaikkan bobot kata khas
ASCII Encoding
ASCII (American Standard Code for Information Interchange) adalah sistem encoding karakter paling dasar. Setiap karakter direpresentasikan dengan angka.
Misalnya, kata "Hello" disimpan sebagai vektor:
Masalah ASCII untuk NLP
ASCII memiliki beberapa keterbatasan untuk pemrosesan bahasa alami:
- Tidak menangkap arti kata - "good" dan "great" memiliki arti mirip tapi direpresentasikan sangat berbeda
- Tidak menangkap relasi antar kata - "good" dan "bad" adalah antonim tapi tidak ada hubungan dalam representasi ASCII
Simulasi: ASCII Encoding
Mari kita lihat bagaimana teks diubah menjadi kode ASCII:
Setiap karakter memiliki kode ASCII unik. Contoh: 'H' = 72, 'e' = 101, 'l' = 108, 'o' = 111
One-Hot Encoding
One-Hot Encoding adalah cara merepresentasikan kata sebagai vektor angka.
Setiap kata mendapat posisi/indeks unik dalam vocabulary, lalu dibuatkan vektor
yang bernilai 1
hanya di posisi kata tersebut, dan 0
di semua posisi lainnya.
Kalimat: "the cat sat on the mat" → 5 kata unik
| Kata |
0 the |
1 cat |
2 sat |
3 on |
4 mat |
Vektor |
|---|---|---|---|---|---|---|
| the #0 | 1 | 0 | 0 | 0 | 0 | [1, 0, 0, 0, 0] |
| cat #1 | 0 | 1 | 0 | 0 | 0 | [0, 1, 0, 0, 0] |
| sat #2 | 0 | 0 | 1 | 0 | 0 | [0, 0, 1, 0, 0] |
| on #3 | 0 | 0 | 0 | 1 | 0 | [0, 0, 0, 1, 0] |
| mat #4 | 0 | 0 | 0 | 0 | 1 | [0, 0, 0, 0, 1] |
💡 Perhatikan pola diagonal — setiap kata hanya punya satu 1 di seluruh vektornya.
💻 Praktik One-Hot & Word Embedding
Eksplorasi One-Hot Encoding, Word Embedding, dan analogi kata secara interaktif di Google Colab
Buka di Google ColabSimulasi: One-Hot Encoding
Ketik kalimat di bawah. Lihat bagaimana setiap kata mendapatkan posisi unik dalam vocabulary, diubah menjadi vektor one-hot, lalu dijumlahkan menjadi vektor kalimat.
Bag of Words (BoW)
Bag of Words adalah langkah lanjutan dari one-hot: kita menjumlahkan semua vektor one-hot dari kata-kata dalam sebuah kalimat/dokumen, sehingga satu dokumen diwakili oleh satu vektor berisi frekuensi kemunculan kata.
Jumlahkan semua vektor one-hot dari setiap kata dalam kalimat → dapat 1 vektor per kalimat.
| Kata | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| the | 1 | 0 | 0 | 0 | 0 |
| cat | 0 | 1 | 0 | 0 | 0 |
| sat | 0 | 0 | 1 | 0 | 0 |
| Σ Kalimat | 1 | 1 | 1 | 0 | 0 |
Contoh dengan Tiga Dokumen
Dokumen 1: "saya suka python"
Dokumen 2: "saya suka machine learning"
Dokumen 3: "python bagus untuk machine learning"
Vocabulary: [bagus, untuk, learning, machine, python, saya, suka]
Vektor Dokumen 1: [0, 0, 0, 0, 1, 1, 1]
Vektor Dokumen 2: [0, 0, 1, 1, 0, 1, 1]
Vektor Dokumen 3: [1, 1, 1, 1, 1, 0, 0]
Kelebihan:
- Sederhana dan mudah dipahami
- Cepat untuk diimplementasikan
- Efektif untuk banyak tugas klasifikasi teks
Kekurangan:
- Tidak mempertimbangkan urutan kata
- Tidak membedakan kata penting vs tidak penting
- Menghasilkan vektor yang sparse (banyak nilai 0)
Term Frequency (TF)
Bag of Words memakai hitungan mentah. Masalahnya, dokumen yang panjang otomatis punya angka yang lebih besar walaupun topiknya sama. Term Frequency (TF) memperbaiki ini dengan menormalisasi hitungan terhadap panjang dokumen.
Contoh Perhitungan
Gunakan tiga dokumen yang sama seperti pada BoW:
D1: "saya suka python" (3 kata)
D2: "saya suka machine learning" (4 kata)
D3: "python bagus untuk machine learning" (5 kata)
| Kata | TF di D1 | TF di D2 | TF di D3 |
|---|---|---|---|
| saya | 1/3 = 0.33 | 1/4 = 0.25 | 0 |
| suka | 1/3 = 0.33 | 1/4 = 0.25 | 0 |
| python | 1/3 = 0.33 | 0 | 1/5 = 0.20 |
| machine | 0 | 1/4 = 0.25 | 1/5 = 0.20 |
| learning | 0 | 1/4 = 0.25 | 1/5 = 0.20 |
| bagus | 0 | 0 | 1/5 = 0.20 |
| untuk | 0 | 0 | 1/5 = 0.20 |
Masih ada masalah: kata seperti "saya", "yang", "dan" tetap mendapat nilai tinggi padahal muncul di hampir semua dokumen dan hampir tidak membawa informasi. Inilah yang diperbaiki oleh TF-IDF.
TF-IDF: Term Frequency - Inverse Document Frequency
TF-IDF memberikan bobot lebih tinggi pada kata yang sering muncul dalam dokumen tertentu tapi jarang muncul di dokumen lain.
Komponen TF-IDF:
- TF (Term Frequency): Seberapa sering kata muncul dalam dokumen
- IDF (Inverse Document Frequency): Seberapa unik kata tersebut di seluruh koleksi dokumen
IDF(kata) = ln( Total Dokumen / Jumlah Dokumen yang mengandung kata )
Menghitung IDF
Dengan 3 dokumen yang sama (N = 3):
| Kata | Muncul di berapa dokumen (df) | IDF = ln(3 / df) | Interpretasi |
|---|---|---|---|
| saya | 2 | ln(1.5) = 0.41 | Umum → bobot kecil |
| python | 2 | ln(1.5) = 0.41 | Umum → bobot kecil |
| machine | 2 | ln(1.5) = 0.41 | Umum → bobot kecil |
| bagus | 1 | ln(3) = 1.10 | Khas → bobot besar |
| untuk | 1 | ln(3) = 1.10 | Khas → bobot besar |
TF-IDF = TF × IDF
Contoh untuk Dokumen 3 ("python bagus untuk machine learning"):
| Kata | TF | IDF | TF-IDF |
|---|---|---|---|
| python | 0.20 | 0.41 | 0.08 |
| machine | 0.20 | 0.41 | 0.08 |
| bagus | 0.20 | 1.10 | 0.22 |
| untuk | 0.20 | 1.10 | 0.22 |
Semua kata punya TF yang sama (0.20), tetapi setelah dikalikan IDF, kata yang khas untuk dokumen itu mendapat skor hampir tiga kali lipat. Inilah cara TF-IDF menonjolkan kata yang benar-benar membedakan sebuah dokumen dari dokumen lain.
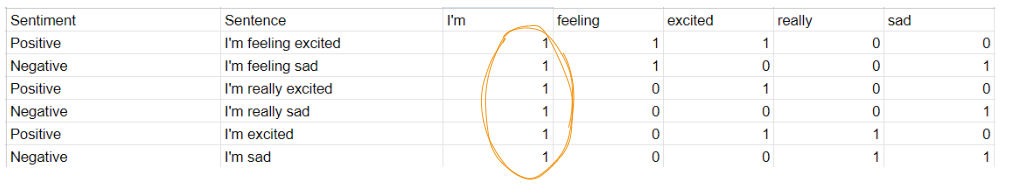
📊 Lihat Spreadsheet Interaktif
Eksplorasi perhitungan BoW & TF-IDF secara detail dengan spreadsheet interaktif
Buka Google SpreadsheetBatas Akhir Pendekatan Klasik
TF-IDF adalah puncak dari representasi berbasis hitungan. Tapi tetap saja: "raja" dan "ratu" masih dianggap dua dimensi yang sama sekali tidak berhubungan. Untuk menangkap makna, kita perlu pindah ke Statistical Word Embedding.