Selamat Datang di Pembelajaran NLP!
Apa itu Natural Language Processing (NLP)? NLP adalah bidang kecerdasan buatan yang memungkinkan komputer memahami, menginterpretasi, dan menghasilkan bahasa manusia dengan cara yang bermakna.
Dalam pembelajaran ini, kita akan memahami:
- Aplikasi NLP yang kita pakai sehari-hari
- Ragam task NLP dan bentuk output-nya
- Bagaimana mesin memahami bahasa manusia
- Konsep preprocessing dan pentingnya
- Word embedding dan konteks kata
- Cara model seperti ChatGPT menghasilkan teks
NLP di Sekitar Kita
NLP bukan teknologi masa depan yang masih di laboratorium. Kita sudah memakainya puluhan kali setiap hari tanpa sadar. Setiap kali Anda mengetik pesan, mencari sesuatu di Google, atau membaca artikel terjemahan, ada model NLP yang bekerja di baliknya.
Berikut contoh produk yang mungkin sudah Anda pakai hari ini:
Grammarly
Mengoreksi ejaan dan tata bahasa saat Anda mengetik, menilai nada tulisan (formal, ramah, percaya diri), lalu menyarankan kalimat pengganti yang lebih jelas.
Grammar CorrectionGoogle Translate
Menerjemahkan teks, suara, bahkan tulisan di dalam foto ke lebih dari 100 bahasa — termasuk bahasa daerah seperti Jawa dan Sunda.
Machine TranslationFilter Spam Gmail
Membaca isi setiap email masuk dan memutuskan mana yang layak masuk inbox, mana yang promosi, dan mana yang spam atau penipuan.
Text ClassificationSiri & Google Assistant
Mengubah suara Anda menjadi teks, menebak maksud perintahnya ("nyalakan alarm jam 6"), lalu menjalankan aksi yang sesuai.
Speech + Intent DetectionGoogle Search
Memahami maksud di balik kata kunci, bukan sekadar mencocokkan huruf. Mencari "obat sakit kepala anak" tetap dapat hasil relevan walau halamannya menulis "pereda nyeri untuk balita".
Semantic SearchAutocomplete & Smart Compose
Menebak kata atau bahkan kalimat berikutnya saat Anda mengetik di keyboard HP maupun di Gmail — prinsipnya sama dengan mesin di balik ChatGPT, hanya lebih kecil.
Language ModelingAnalisis Ulasan E-commerce
Merangkum ribuan ulasan Tokopedia atau Shopee menjadi skor sentimen dan daftar keluhan yang paling sering muncul.
Sentiment AnalysisChatGPT & Claude
Menjawab pertanyaan, meringkas dokumen panjang, sampai menulis dan memperbaiki kode — semuanya dalam bentuk percakapan.
Text GenerationSubtitle Otomatis YouTube
Mengubah suara dalam video menjadi teks, lalu menerjemahkannya ke bahasa lain secara otomatis.
Speech-to-TextThe Black Box
Pernahkah Anda bertanya-tanya bagaimana ChatGPT atau model AI lainnya bisa menjawab pertanyaan Anda dengan sangat natural? Mari kita buka "black box" ini!

Tapi bagaimana sebenarnya mesin bisa memahami bahasa kita? Mari kita pelajari langkah demi langkah!
Mesin Hanya Memahami Angka
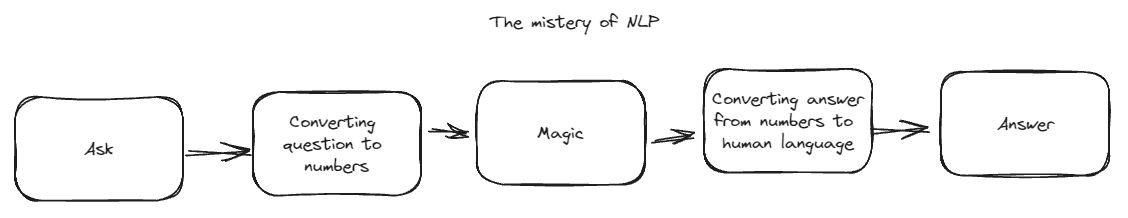
Fakta fundamental: Komputer hanya bisa memproses angka. Setiap perhitungan machine learning pada dasarnya adalah operasi matematika seperti perkalian matriks dan fungsi aktivasi.
Untuk mengubah bahasa menjadi angka, kita memerlukan beberapa tahap:
- Preprocessing: Membersihkan teks dari noise
- Tokenization: Memecah teks menjadi unit-unit kecil
- Word Embedding: Mengubah kata menjadi vektor angka
Task-Task dalam NLP
Produk seperti Grammarly atau ChatGPT sebenarnya tersusun dari sekumpulan task NLP yang standar. Mengenali task ini penting: ketika Anda menghadapi masalah baru di dunia kerja, pertanyaan pertama selalu "ini sebetulnya task NLP yang mana?" — karena dari jawabannya kita menentukan bentuk data, pilihan model, dan metrik evaluasinya.
Pola Dasar Semua Task NLP
Yang membedakan satu task dengan task lain adalah bentuk output-nya: sebuah label, potongan teks yang ditandai, atau teks baru sepenuhnya.
Output-nya berupa label, tanda, atau skor. Model membaca, tidak menulis.
Text Classification
Memberi satu label untuk keseluruhan teks. Ini task paling umum dan biasanya jadi proyek NLP pertama: analisis sentimen, deteksi spam, atau pelabelan topik tiket support.
Output: positif (0.98)
Named Entity Recognition (NER)
Menandai potongan teks yang merupakan nama orang, tempat, organisasi, tanggal, atau nominal uang. Berguna untuk mengekstrak data terstruktur dari dokumen seperti invoice dan kontrak.
Output: Budi → PERSON, BCA → ORG, 5 Oktober → DATE
Part-of-Speech Tagging
Menandai kelas kata setiap token: kata benda, kata kerja, kata sifat. Sering jadi langkah bantu untuk task lain yang lebih besar.
Output: Andi/NOUN membaca/VERB buku/NOUN tebal/ADJ
Question Answering (Ekstraktif)
Menemukan jawaban di dalam dokumen yang diberikan, bukan mengarangnya sendiri. Model hanya menunjuk potongan teks yang paling menjawab pertanyaan.
Tanya: "Di mana kantor pusat Gojek?"
Output: "Jakarta"
Semantic Search & Text Similarity
Mengukur seberapa mirip makna dua teks, meski pilihan katanya berbeda. Ini fondasi mesin pencari, sistem rekomendasi, dan RAG.
Teks B: "lupa password, gimana ya?"
Output: kemiripan 0.91
Topic Modeling & Clustering
Mengelompokkan ribuan dokumen tanpa label menjadi beberapa tema. Dipakai saat kita belum tahu kategori apa yang ada di dalam data.
Output: Topik 1: pembayaran, Topik 2: pengiriman, Topik 3: retur
Output-nya berupa teks baru. Model tidak hanya membaca, tapi juga menulis.
Machine Translation
Menerjemahkan teks dari satu bahasa ke bahasa lain sambil menjaga makna dan konteksnya, bukan menerjemahkan kata per kata.
Output: "I am really hungry"
Text Summarization
Memadatkan dokumen panjang menjadi ringkasan. Ada dua gaya: ekstraktif (memilih kalimat terpenting) dan abstraktif (menulis ulang dengan kalimat sendiri).
Output: ringkasan 3 kalimat
Text Generation
Melanjutkan teks dengan memprediksi kata berikutnya, satu per satu. Inilah mesin utama di balik ChatGPT — kita bahas lebih detail di bagian "One Word at a Time".
Output: " Jakarta"
Dialogue System & Chatbot
Merespons pengguna sambil mengingat riwayat percakapan, sehingga jawaban di giliran kelima tetap nyambung dengan pertanyaan di giliran pertama.
Bot: "Boleh saya tahu nomor pesanannya?"
Paraphrasing & Grammar Correction
Menulis ulang kalimat agar lebih jelas atau benar secara tata bahasa. Ini persis yang dilakukan Grammarly pada contoh di bagian sebelumnya.
Output: "Kemarin saya pergi ke pasar dan membeli sayur."
Satu Aplikasi = Gabungan Beberapa Task
Mari kita kembali ke contoh-contoh tadi dan bongkar task penyusunnya:
| Aplikasi | Task NLP yang Dipakai |
|---|---|
| Grammarly | Grammar correction + klasifikasi nada tulisan + paraphrasing |
| Google Translate | Deteksi bahasa (klasifikasi) + machine translation |
| Filter spam Gmail | Text classification |
| Google Search | Semantic search + question answering |
| ChatGPT & Claude | Text generation + summarization + QA + dialogue |
| Dashboard ulasan produk | Sentiment analysis + NER (nama produk) + topic modeling |
Demo: Melihat Word Embedding
Mari kita lihat word embedding untuk kata tertentu menggunakan GloVe embeddings yang populer.
💻 Praktikkan di Google Colab
Yuk, jalankan code dan lihat word embedding secara langsung!
Buka di Google ColabOne Word at a Time: Cara Model Menghasilkan Teks
Perhatikan bagaimana ChatGPT atau model AI lainnya menjawab pertanyaan: mereka menghasilkan teks satu kata pada satu waktu, dari kiri ke kanan!
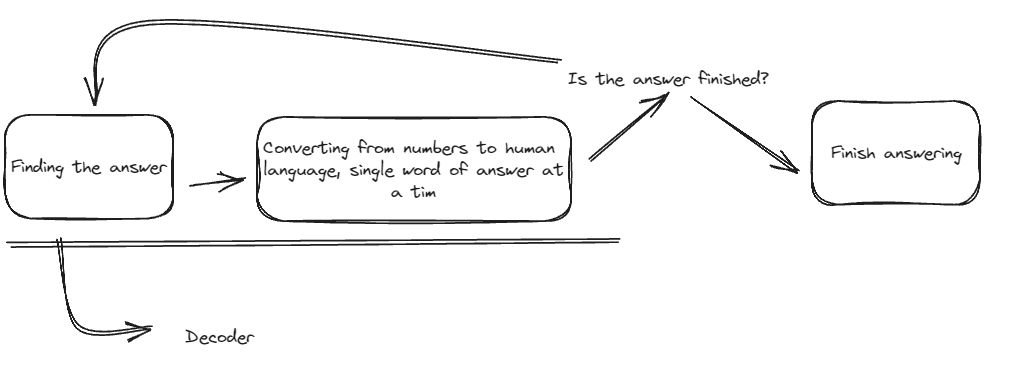
Proses Generasi Teks
Input: "Apa kabar?"
Step 1: Generate → "Baik"
Step 2: Generate → "Baik, terima"
Step 3: Generate → "Baik, terima kasih"
Step 4: Generate → "Baik, terima kasih!" [STOP]
Pada setiap step:
- Model melihat input asli + kata-kata yang sudah dihasilkan
- Model memprediksi kata berikutnya yang paling cocok
- Proses berlanjut sampai model memutuskan untuk berhenti
Rangkuman: Perjalanan NLP
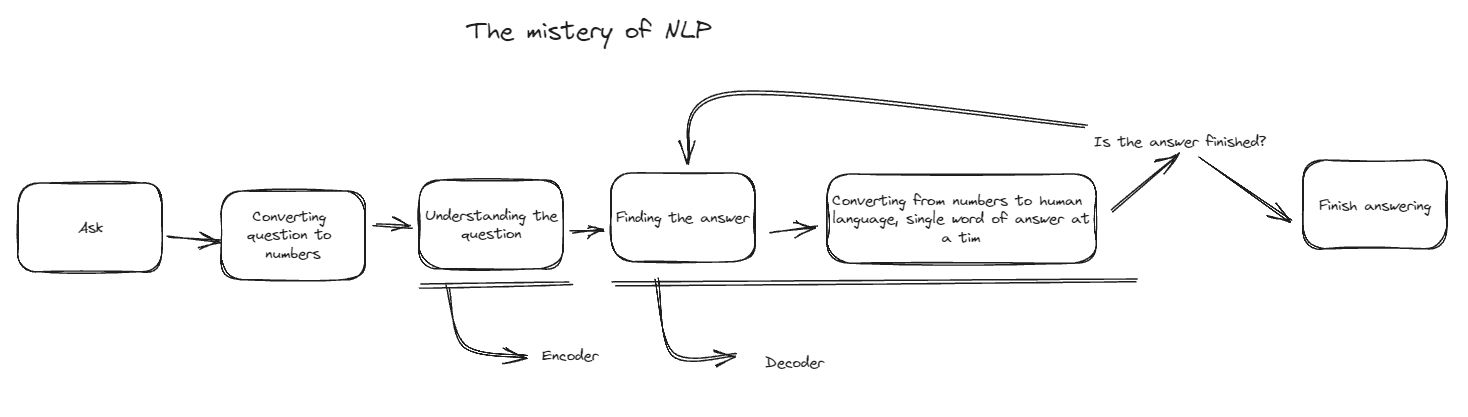
Selamat! Anda telah memahami intuisi dasar tentang bagaimana Natural Language Processing bekerja. Mari kita rangkum:
Poin-Poin Penting
- NLP ada di sekitar kita: Grammarly, Google Translate, filter spam, sampai chatbot
- Ragam task NLP terbagi dua: memahami teks (NLU) dan menghasilkan teks (NLG)
- Yang membedakan antar task adalah bentuk output-nya: label, tanda, atau teks baru
- Mesin hanya memahami angka, jadi teks harus diubah dulu
- Preprocessing membersihkan teks dari noise
- Word embedding merepresentasikan kata sebagai vektor multidimensi
- Model menghasilkan teks satu kata pada satu waktu